Plataforma de Dados — Solução para Consumo (Parte 2)
Na arquitetura de uma Plataforma de Dados, a camada de consumo engloba as ferramentas de persistência, armazenamento, catalogação e processamento de dados. Como mencionei nos desafios, o principal problema das soluções comerciais de Data Warehouse reside em sua natureza altamente acoplada e baixa escalabilidade.
Antes de avançarmos para o projeto da Plataforma, é importante revisitar a arquitetura de um Sistema de Gerenciamento de Banco de Dados (DBMS) genérico, que servirá como base para nossa solução.
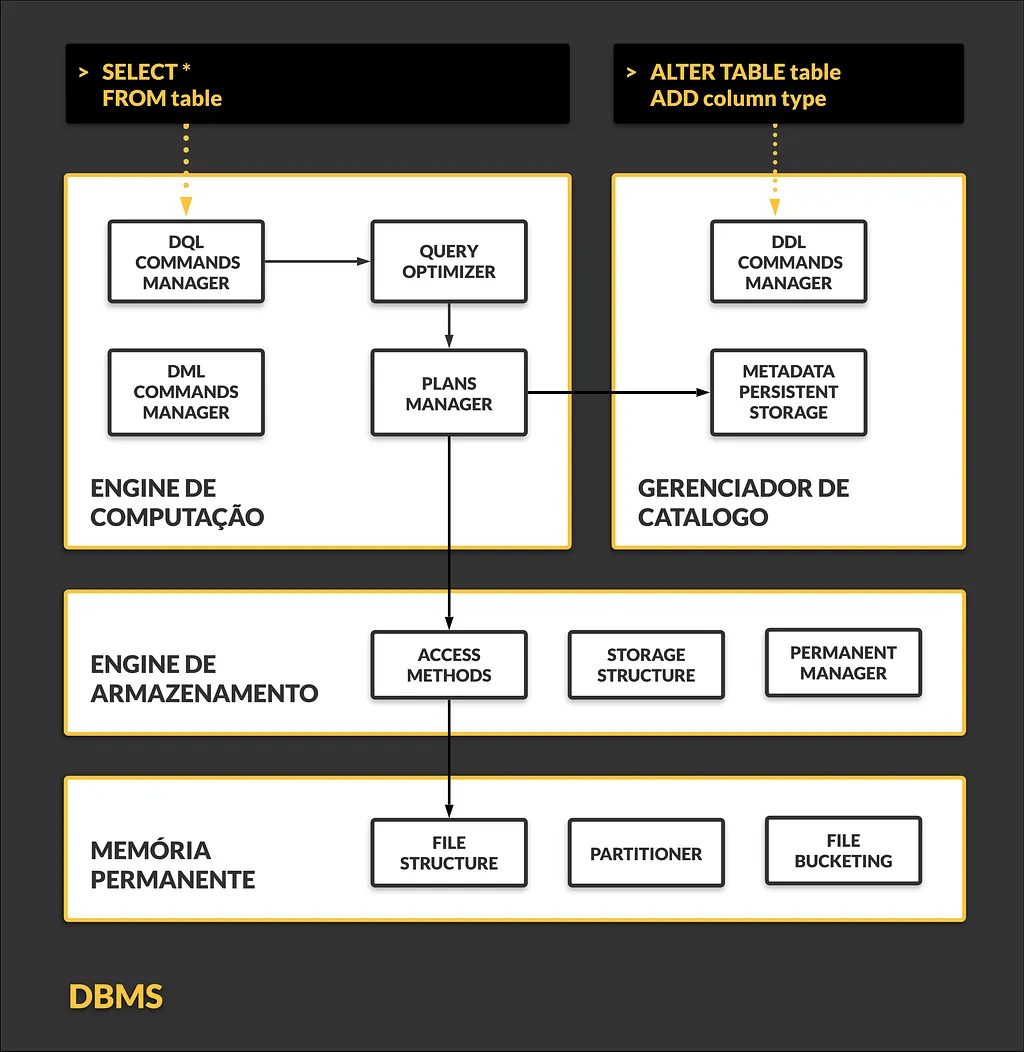
Arquitetura de Sistemas de Gerenciamento de Banco de Dados
A arquitetura acima pode ser dividida em quatro componentes principais:
- Engine de Computação: Este componente é responsável por receber a consulta (query), coordenar sua execução e realizar todas as transformações e agregações necessárias.
- Gerenciador de Catálogo: Local onde são armazenadas as informações sobre a estrutura das tabelas e os metadados correspondentes.
- Engine de Armazenamento: Define as unidades lógicas do banco de dados e os métodos de acesso aos dados.
- Memória Permanente: Camada de persistência onde os dados são efetivamente armazenados.
Agora, exploraremos cada um desses componentes em detalhes, reconstruindo cada parte para desenvolver a nossa própria solução de consumo na Plataforma de Dados.
Memória Permanente
Este é o nosso ponto de partida, o local onde os dados são efetivamente armazenados. Levando em consideração os desafios enfrentados pela nossa plataforma, as características desejadas para a memória permanente incluem:
- Capacidade de escalabilidade fácil.
- Possibilidade de consumo distribuído, a fim de evitar que se torne um gargalo no desempenho.
No mercado, as duas soluções mais comuns são o Object Storage e o Sistema de Arquivos Distribuído (por exemplo, HDFS). Para ilustrar, apresento uma tabela com algumas das diferenças principais, utilizando como referência a nuvem da AWS:
| Critério | Distributed File System (EBS) | Object Storage (S3) |
|---|---|---|
| Preço | > US$ 0,100 | US$ 0,023 |
| Largura de banda | > 250 MB/s | 350 MB/s |
| Paralelismo | Precisa implementar | Built-in |
| Escalabilidade | Manual | Automática |
| Manutenção | Frequente | Rara |
Os Sistemas de Arquivos Distribuídos, apesar dos custos e das taxas de manutenção elevadas, justificam sua utilização pelo desempenho altamente escalável. Isso ocorre porque suas taxas de transferência não são limitadas, dependendo exclusivamente das configurações do cluster.
Por outro lado, os Object Storage, embora apresentem taxas de transferência limitadas pelo provedor, representam uma opção muito mais acessível e exigem quase nenhuma manutenção. Essas características os tornaram a escolha predominante na maioria das Plataformas de Dados.
Dessa forma, optar por um Object Storage (como o S3) para nossa memória permanente parece ser a decisão mais fácil.
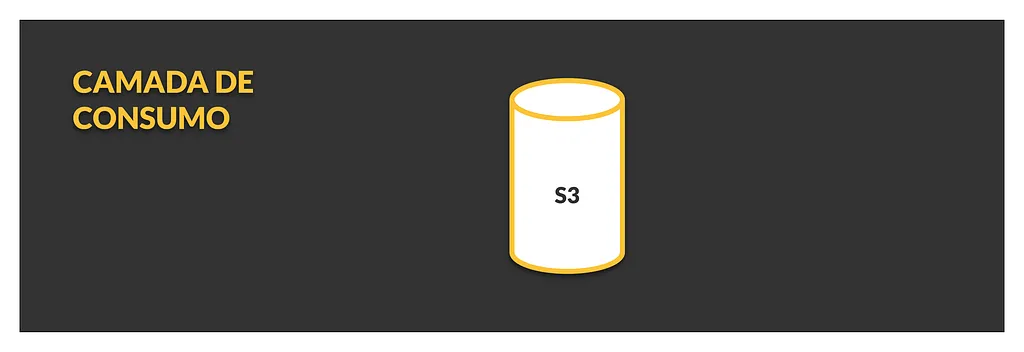
Arquitetura da camada de consumo com a Memória Permanente
Engine de Armazenamento
O próximo passo envolve definir o formato de serialização dos dados a serem armazenados na Memória Permanente, que será utilizado pela Engine de Armazenamento.
Para atender às demandas analíticas de uma Plataforma de Dados, buscamos uma serialização otimizada para leitura e agregação. Os formatos colunares destacam-se por serem extremamente eficientes para esses propósitos. Entre eles, Parquet e ORC emergem como dois dos formatos colunares mais adotados, permitindo-nos estabelecer uma comparação inicial:
| Critério | Parquet | ORC |
|---|---|---|
| Performance de leitura | Alta | Altíssima |
| Compressão | Média | Alta |
| Ecossistema mais adequado | Impala, Arrow, Drill e Spark | Hive e Presto |
O desempenho do ORC tende a ser superior em benchmarks disponíveis na internet e, na maioria dos casos práticos, isso pode ser atribuído às estatísticas dos dados que são incorporadas diretamente no arquivo, além de sua compressão mais eficaz. No entanto, a decisão entre os dois formatos pode não ser tão complexa, visto que as diferenças entre eles não são substanciais. O que frequentemente determina a escolha é o ecossistema ao qual a arquitetura pertence. Para a nossa Plataforma, optaremos pelo ORC.
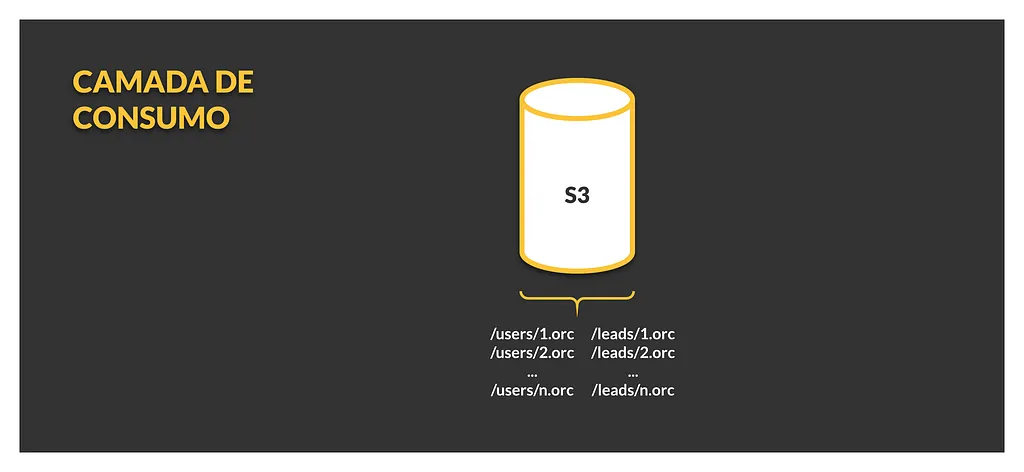
Arquitetura da camada de consumo com a Engine de Armazenamento
Gerenciador de Catálogo
A função primordial do Gerenciador de Catálogo é armazenar as definições das tabelas e seus respectivos metadados. Idealmente, procuramos por uma ferramenta que seja intrinsecamente modular, permitindo seu uso por diferentes sistemas e centralizando a gestão das definições de dados e tabelas. No mercado, as opções disponíveis são limitadas, com o Hive Metastore sendo a escolha predominante para a maioria das Plataformas de Dados. Para a nossa Plataforma, esta escolha não precisa ser diferente, considerando a facilidade de integração do Hive Metastore com as ferramentas mais usuais do ecossistema de dados.
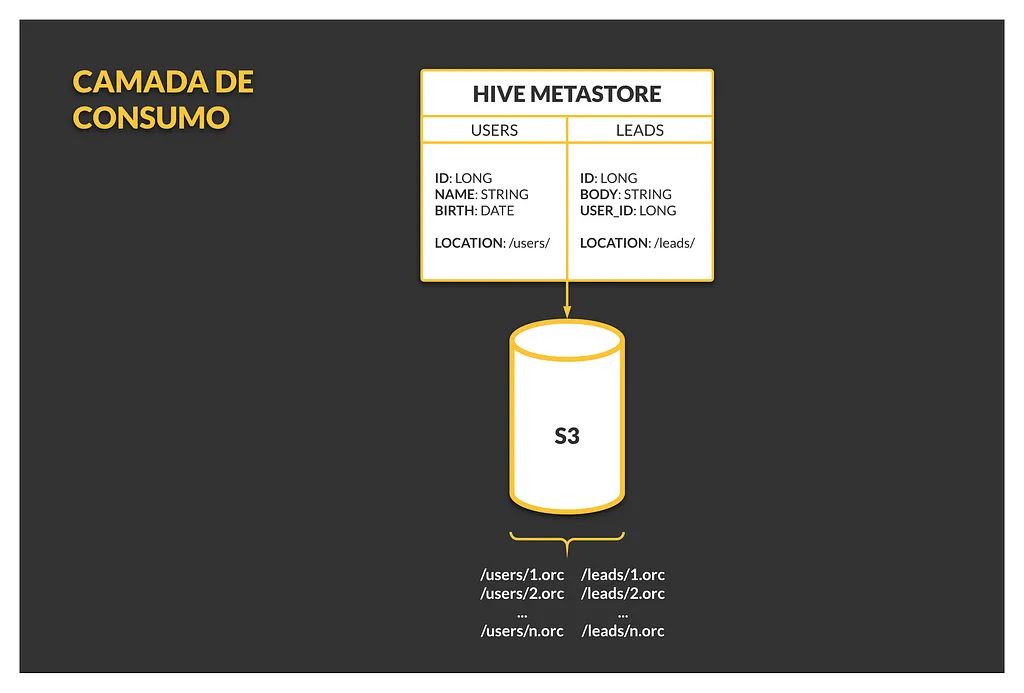
Arquitetura da camada de consumo com a Gerenciador de Catálogo
Engine de Computação
A Engine de Computação é o motor do consumo e também serve como a principal interface para os usuários, desempenhando um papel crucial em nossa Plataforma. É ela que recebe a consulta do usuário, transcreve-a para sua árvore de execução, otimiza sua estrutura, coordena a projeção a ser enviada para as camadas de armazenamento, executa todas as operações da Álgebra Relacional e retorna o resultado ao usuário. Dada a sua importância, a escolha desta componente é uma das mais desafiadoras, com várias opções disponíveis. Neste texto, no entanto, focaremos nas duas principais soluções:
- PrestoDB: Query Engine focada na execução de consultas com excelente conformidade ANSI-SQL, ideal para queries imediatas e Ad Hoc, e capaz de federar múltiplas bases de dados distintas.
- Spark: Um General Compute Engine para computação distribuída de propósito geral, oferecendo uma DSL em Python, Java e Scala que facilita a análise exploratória e a construção de aplicações. É voltado para aplicações e queries de longa duração, excelendo na manipulação e persistência de dados.
Ambas as ferramentas possuem qualidades distintas, destacando-se em suas respectivas áreas de aplicação e atendendo a casos de uso diferentes. Na maioria dos cenários, Cientistas de Dados e Desenvolvedores se beneficiam da flexibilidade oferecida pelo Spark através de sua DSL programática disponível em várias linguagens de programação, além da interface SQL. O Spark foi projetado com a premissa de que falhas de processamento são inevitáveis, tornando suas computações altamente tolerantes a falhas e fazendo dele um framework robusto para desenvolvimento de aplicações.
Por outro lado, Analistas de Dados e usuários familiarizados com a interface SQL se beneficiam da natureza do PrestoDB, otimizada para consultas Ad Hoc. Ele é praticamente dedicado a queries analíticas rápidas, e, por isso, muitos benchmarks demonstram seu desempenho superior para essa finalidade.
Com uma arquitetura suficientemente modular, não é necessário escolher exclusivamente entre uma opção ou outra; na maioria dos casos, optaremos por ambas para atender a necessidades diversas. Portanto, o desenho final de nossa arquitetura de consumo na Plataforma de Dados seria:
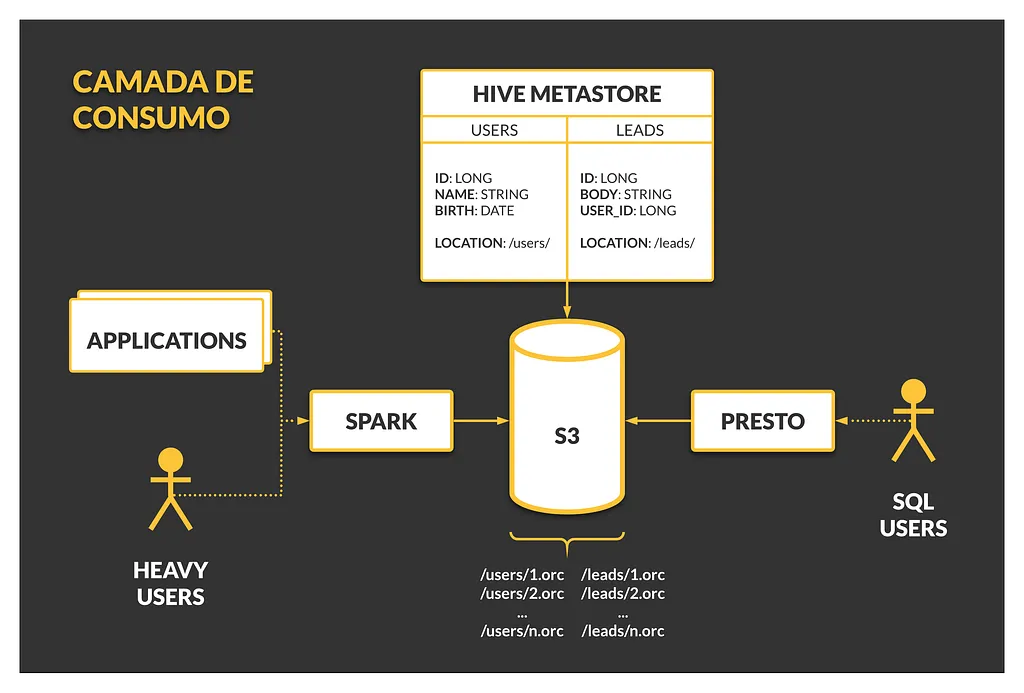
Arquitetura da camada de consumo com as Engines de Computação
Com esta Arquitetura, já conseguimos superar muitos dos desafios anteriormente mencionados, através do desacoplamento dos sistemas, proporcionando armazenamento e processamento de alta escalabilidade, além de um catálogo de dados que centraliza as informações estruturais das tabelas, disponível para diversas ferramentas de consumo adaptadas a necessidades específicas.
Parece que estamos quase prontos para iniciar o consumo dos dados. No entanto, surge uma questão fundamental: de onde vêm esses dados? É esse o ponto que abordaremos no próximo tópico, explorando as origens dos dados e como eles são integrados à nossa Plataforma de Dados.